Maßgeschneiderte KI-Assistenten: Was Entscheider über RAG wissen sollten
Von Martin Feld · Veröffentlicht am · Aktualisiert am
Wie ein KI-Assistent Unternehmenswissen per RAG einbeziehen kann, welche Voraussetzungen zu prüfen sind und wo Suche und Sprachmodell Grenzen haben.
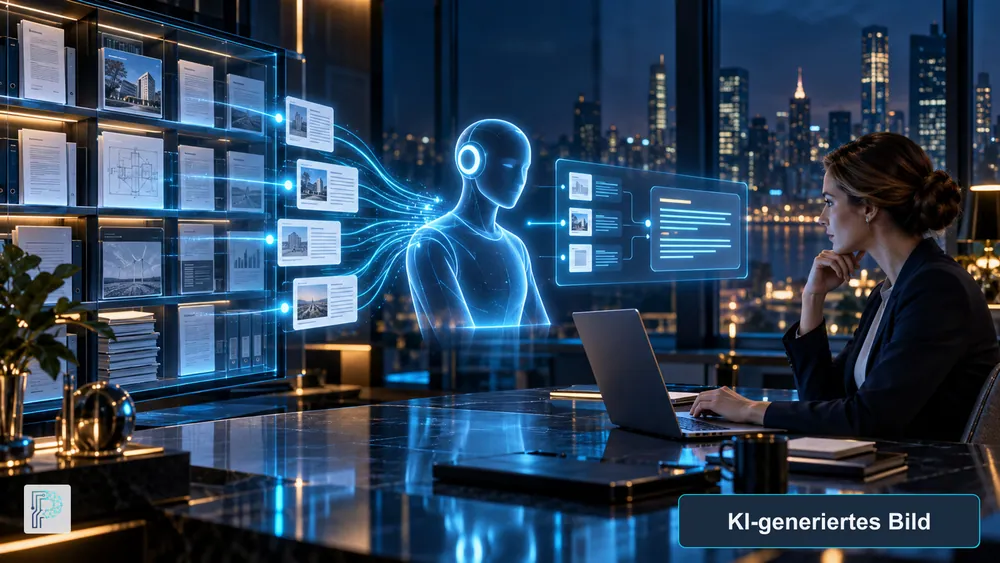
Ein KI-Assistent, der internes Wissen berücksichtigt, braucht mehr als ein Sprachmodell. Häufig wird dafür Retrieval-Augmented Generation (RAG) eingesetzt: Eine Anwendung sucht zu einer Anfrage passende Inhalte aus angebundenen Quellen und übergibt sie dem Sprachmodell als Kontext. Was das für eine Organisation leisten kann, hängt von Suche, Quellen, Berechtigungen und Antwortprüfung ab.
Dieser Beitrag ordnet das Konzept für Entscheider ein. Technische Fehlerquellen und Prüfschritte für RAG-Anwendungen behandelt ergänzend der Beitrag RAG-Assistenten für Unternehmenswissen: Möglichkeiten und Grenzen.
Was ein maßgeschneiderter Assistent umfasst
„Maßgeschneidert“ bezeichnet kein einheitliches Produkt oder eine bestimmte Architektur. Gemeint sein kann eine Anwendung, die für einen konkreten Zweck eingerichtet wird, etwa mit definierten Aufgaben, angebundenen Informationsquellen oder Abläufen. Vor einer Auswahl sollte deshalb geklärt werden, welche Funktion gebraucht wird und woran sich eine geeignete Antwort erkennen lässt.
Ein Sprachmodell erzeugt Antworten auf Basis seiner Eingabe und seines Trainings. Es kennt dadurch nicht automatisch aktuelle interne Dokumente oder betriebliche Regeln. Eine angebundene Suche kann ausgewählte externe Inhalte in den Antwortkontext bringen, sofern die Anwendung sie findet und korrekt verarbeitet. Sie verändert das Modelltraining nicht automatisch.
RAG in drei Schritten
Ein typischer RAG-Ablauf besteht aus:
- Abrufen: Die Anwendung sucht zu einer Frage relevante Inhalte in einer Wissensquelle oder einem Suchindex.
- Kontext ergänzen: Gefundene Passagen werden zusammen mit der Frage an das Sprachmodell übergeben.
- Antwort erzeugen: Das Modell formuliert daraus eine Antwort. Die Anwendung kann zusätzlich Verweise auf verwendete Quellen anzeigen.
Die ursprüngliche RAG-Arbeit von Lewis et al. untersucht eine konkrete Architektur für wissensintensive NLP-Aufgaben. Sie ist ein Forschungsbeitrag und kein Nachweis dafür, dass jede heutige Unternehmenslösung zuverlässig oder für einen bestimmten Zweck geeignet ist. Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
Wissen, Aktualität und Grenzen
Eine angebundene Wissensquelle kann Inhalte außerhalb des Modelltrainings bereitstellen. Daraus folgt jedoch nicht, dass das System stets die neueste oder passende Fassung verwendet. Das hängt unter anderem davon ab, wie Änderungen übernommen, Suchindizes aktualisiert und widersprüchliche Dokumente behandelt werden.
Fehler können an mehreren Stellen entstehen: Die relevante Information fehlt, die Suche findet ungeeignete Passagen oder das Modell gibt den Kontext falsch wieder. Auch Quellenverweise sind kein Beleg dafür, dass jede Aussage von den angezeigten Dokumenten getragen wird. NIST führt plausible, aber falsche Ausgaben generativer KI als Risiko auf. Wichtige Antworten müssen daher anhand der Originalquelle überprüft werden. NIST, Generative Artificial Intelligence Profile (2024)
RAG erschließt außerdem kein Wissen, das in den angebundenen Quellen nicht dokumentiert ist. Es prüft nicht automatisch, ob eine Aussage fachlich oder rechtlich zulässig ist, und ersetzt keine verantwortliche Entscheidung.
Qualität und Zugriffsrechte einplanen
Vor einem Pilot sollten typische Fragen und die jeweils erwarteten Quellen festgelegt werden. Prüfen Sie Suche und Antwort getrennt: Wurden die relevanten Passagen gefunden, und gibt die Antwort deren Inhalt korrekt wieder? Nehmen Sie auch Fälle mit fehlenden, veralteten oder widersprüchlichen Informationen auf. Legen Sie fest, wann der Assistent Unsicherheit anzeigen, auf eine zuständige Person verweisen oder keine Antwort geben soll.
Wenn die Wissensbasis geschützte Informationen enthält, muss die konkrete Architektur sicherstellen, dass Nutzer nur für sie freigegebene Inhalte abrufen können. Ebenso sind Datenübertragungen, Protokolle, Indizes und die Verantwortlichkeit für die Quellenpflege zu klären. Diese Eigenschaften sind produkt- und konfigurationsabhängig und lassen sich nicht allein aus dem Begriff RAG ableiten.
Wann eine vertiefte Prüfung sinnvoll sein kann
Ein möglicher Prüfgegenstand sind klar eingegrenzte Arbeitsabläufe mit wiederkehrenden Fragen zu dokumentierten Informationen. Entscheidend ist nicht allein die Menge der Dokumente, sondern ob benötigte Inhalte auffindbar, hinreichend aktuell und für den Einsatzzweck freigegeben sind. Zusätzlich sollten Qualitätsmaßstäbe und Zuständigkeiten für laufende Pflege feststehen.
Bewerten Sie den konkreten Fall anhand eines Testsets aus realistischen Fragen, erwarteten Quellen und kritischen Grenzfällen. Ergebnisse eines solchen Tests gelten zunächst für die geprüfte Konfiguration und belegen keine allgemeine Zeitersparnis oder Antwortqualität.
Konzeptionsworkshop als nächster Schritt
Der Workshop „Maßgeschneiderte KI-Assistenten verstehen“ behandelt RAG konzeptionell, ordnet typische Grenzen ein und unterstützt dabei, Fragen für eine spätere Entscheidung zu entwickeln. Er richtet sich auf Verständnis und Einordnung; Entwicklung, Implementierung und Betriebsfreigabe sind nicht sein Gegenstand.
Wenn Sie zunächst den technischen Ablauf und konkrete Qualitäts- und Berechtigungsprüfungen vertiefen möchten, lesen Sie den RAG-Grundlagenbeitrag. Für einen konkreten Einsatzfall sollten Quellen, Nutzergruppen, Datenflüsse und Verantwortlichkeiten zusätzlich individuell geprüft werden.
Häufig gestellte Fragen
Vom Wissen zur Umsetzung
Sie möchten dieses Thema praktisch vertiefen? In unserem Workshop arbeiten wir gemeinsam an konkreten Lösungen für Ihr Unternehmen.
Workshop entdecken