Unternehmensdaten und KI: Welche Voraussetzungen wirklich zählen
Von Martin Feld · Veröffentlicht am · Aktualisiert am
Welche Rolle spielen Unternehmensdaten für KI-Vorhaben? Der Beitrag ordnet Datenqualität, Kontext, Zugriffsrechte und Fachlogik ein und zeigt, was vor einer Entscheidung geprüft werden sollte.
Unternehmensdaten können für ein KI-Vorhaben wichtig sein. Daraus folgt aber weder, dass jedes Vorhaben eigene Daten benötigt, noch dass Datenqualität allein über den Erfolg entscheidet. Entscheidend ist, welche Aufgabe gelöst werden soll, welche Informationen dafür benötigt werden und ob sie im vorgesehenen Verfahren rechtmäßig und verlässlich genutzt werden können.
Allgemeine Modelle und Unternehmenskontext
Ein allgemeines KI-System kann Aufgaben bearbeiten, für die keine internen Informationen erforderlich sind, etwa einen Textentwurf oder eine allgemeine Erklärung. Soll eine Antwort dagegen interne Produktregeln, Prozessschritte oder einen konkreten Geschäftsvorgang berücksichtigen, muss der nötige Kontext auf geeignete Weise bereitgestellt werden. Das kann beispielsweise über Eingaben, eine angebundene Wissensquelle oder eine angepasste Anwendung geschehen. Welche Informationen das System tatsächlich nutzt, hängt von Produkt, Konfiguration und Aufgabe ab.
Auch mit bereitgestellten Unternehmensinformationen kann ein System die fachliche Entscheidung nicht automatisch zuverlässig treffen. Quellen können fehlen, veraltet oder widersprüchlich sein; generierte Ausgaben müssen deshalb für den vorgesehenen Einsatz bewertet werden. Der vertiefende Beitrag zu RAG-Assistenten für Unternehmenswissen und ihren Grenzen erläutert eine mögliche Form des Quellenabrufs.
Welche Daten und Informationen zu prüfen sind
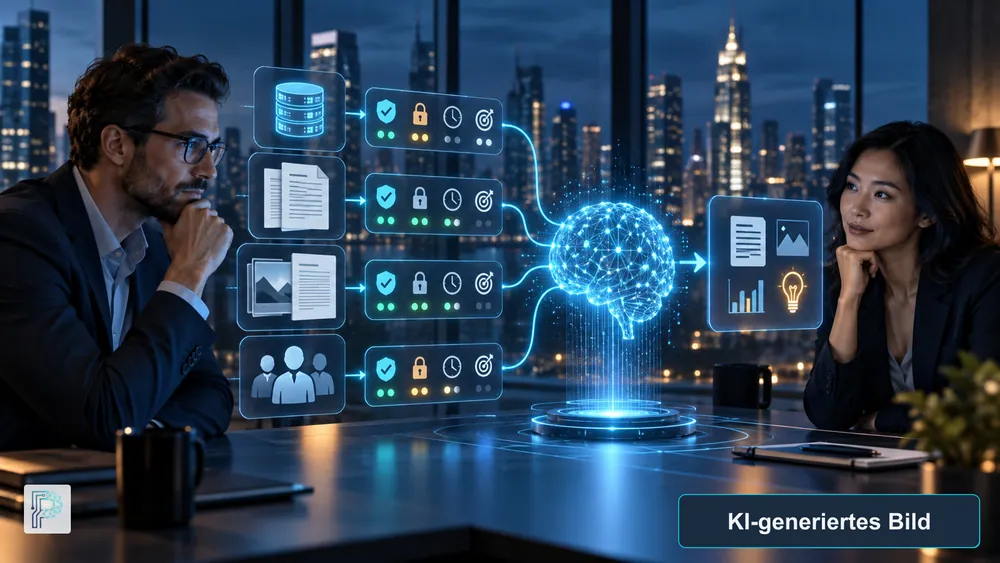
Je nach Anwendungsfall können strukturierte Datensätze, Dokumente, Prozessregeln oder Fachinformationen relevant sein. Eine Quelle wird nicht allein dadurch geeignet, dass sie vorhanden oder umfangreich ist. Prüfen Sie insbesondere:
- Zweck und Herkunft: Wofür wurden die Informationen erhoben oder erstellt, und passen sie zum geplanten Einsatz?
- Qualität und Aktualität: Sind Vollständigkeit, Genauigkeit, Konsistenz und Aktualität für diese Aufgabe ausreichend? Diese Eigenschaften können gegeneinander abzuwägen sein.
- Abdeckung und Grenzen: Bilden die Daten den relevanten Kontext ab? Welche Gruppen, Fälle oder Ausnahmen fehlen möglicherweise?
- Zugriff und Nutzung: Wer darf auf die Quelle zugreifen, und ist die geplante Verarbeitung zulässig?
- Verantwortung: Wer korrigiert Fehler, pflegt Quellen und entscheidet bei widersprüchlichen Angaben?
Das Government Data Quality Framework beschreibt Datenqualität unter anderem anhand von Genauigkeit, Vollständigkeit, Konsistenz und Aktualität und betont, dass die jeweils passende Gewichtung vom Verwendungszweck abhängt. Es ist eine allgemeine Orientierung, keine spezielle KI-Prüfnorm.
Auch das NIST AI Risk Management Framework verknüpft Bewertung mit Kontext und vorgesehenem Einsatz: Systeme sollen für Bedingungen ähnlich dem späteren Einsatz evaluiert werden; Grenzen der Übertragbarkeit sind zu dokumentieren. Das Framework ist freiwillig und wird überarbeitet. Es liefert keine allgemeine Rangliste, welche Datenprobleme in Unternehmen am häufigsten zu Projektmisserfolg führen.
Datenqualität ist zweckbezogen
„Gute Daten“ ist keine einzelne, universelle Eigenschaft. Für eine aktuelle Bestandsauskunft kann Aktualität besonders wichtig sein; für eine Auswertung können Abdeckung und konsistente Definitionen stärker ins Gewicht fallen. Prüfkriterien und Schwellenwerte sollten daher aus der Aufgabe abgeleitet und nachvollziehbar festgelegt werden. Eine vollständige oder einheitliche Datenbasis ist nicht automatisch für jeden Anwendungsfall erforderlich.
Ebenso lässt sich nicht allgemein behaupten, eine spätere Bereinigung sei stets teurer als frühzeitige Datenpflege. Kosten hängen unter anderem davon ab, welche Quellen betroffen sind, welche Qualitätsanforderungen gelten und ob die Informationen überhaupt benötigt werden. Schätzen Sie Aufwand und Nutzen für das konkrete Vorhaben, statt pauschale Einsparungen vorauszusetzen.
Daten und Fachlogik zusammen betrachten
Daten beschreiben Sachverhalte, bilden aber nicht immer die Regeln und Ausnahmen ab, nach denen eine Organisation handelt. Ein Verkaufsrückgang kann beispielsweise verschiedene Ursachen haben; aus der Zahl allein folgt keine Erklärung. Für eine KI-Anwendung müssen deshalb fachliche Begriffe, Entscheidungsregeln und relevante Ausnahmen geklärt werden. Was nicht dokumentiert ist, sollte mit zuständigen Fachpersonen erhoben und als offene Annahme kenntlich gemacht werden.
Das bedeutet nicht, dass jedes implizite Wissen vollständig formalisiert werden muss. Umfang und Tiefe der Erhebung richten sich nach Aufgabe, Folgen möglicher Fehler und benötigter menschlicher Prüfung.
Von der Datenfrage zur tragfähigen Entscheidung
Eine erste Einordnung lässt sich entlang dieser Schritte strukturieren:
- Aufgabe beschreiben: Welcher konkrete Arbeitsschritt soll unterstützt werden, wer nutzt das Ergebnis und welche Fehlerfolgen sind denkbar?
- Benötigten Kontext bestimmen: Welche Daten, Quellen, Regeln oder Prozessinformationen wären dafür tatsächlich nötig?
- Zugang und Eignung prüfen: Klären Sie Herkunft, Qualität, Aktualität, Nutzungsrechte, Berechtigungen und Pflegeverantwortung.
- Optionen vergleichen: Berücksichtigen Sie eine Standardlösung, Prozessänderungen oder den Verzicht auf KI ebenso wie eine individuelle Lösung.
- Ergebnis im Kontext bewerten: Legen Sie geeignete Prüfkriterien fest und dokumentieren Sie Grenzen, offene Fragen und erforderliche menschliche Kontrollen.
Eine Reifegrad- oder Datenanalyse kann diese Fragen strukturieren, ist aber keine allgemeine Erfolgsprognose. Zur Einordnung von Voraussetzungen und offenen Prüffragen lesen Sie auch KI-Reifegrad und Datenanalyse im Unternehmen. Für die Bewertung eines konkreten Vorhabens hilft außerdem der Beitrag zum Realitätscheck von KI-Pilotprojekten.
Der Workshop „Eigene Daten als Grundlage für KI verstehen“ ordnet Datenarten, Datenqualität und Fachlogik konzeptionell ein. Er umfasst laut Beschreibung keine technische Datenaufbereitung oder Implementierung. Klären Sie vor einer Buchung, ob dieser Einordnungsfokus zu Ihrem Anliegen passt.
Quellen und Einordnung
- NIST AI Risk Management Framework 1.0 – Core: freiwillige, kontextbezogene Orientierung; NIST weist auf eine laufende Überarbeitung hin (abgerufen am 2. Oktober 2026).
- Government Data Quality Framework: allgemeine Dimensionen und zweckbezogene Abwägung von Datenqualität (abgerufen am 2. Oktober 2026).
Häufig gestellte Fragen
Vom Wissen zur Umsetzung
Sie möchten dieses Thema praktisch vertiefen? In unserem Workshop arbeiten wir gemeinsam an konkreten Lösungen für Ihr Unternehmen.
Workshop entdecken