Wissensbasierte KI mit AnythingLLM: RAG, Datenflüsse und Grenzen
Von Martin Feld · Veröffentlicht am · Aktualisiert am
Wie wissensbasierte KI mit RAG funktioniert, was AnythingLLM dabei übernimmt und welche Anforderungen an Quellen, Berechtigungen, Betrieb und Qualitätsprüfung bleiben.
Eine KI, die interne Handbücher, Richtlinien und Projektdokumentationen kennt, klingt nach einer einfachen Lösung für verstreutes Unternehmenswissen. Technisch handelt es sich jedoch nicht um ein Modell, das nach dem Hochladen einiger Dateien dauerhaft „dazulernt“. Meist wird eine Suche mit einem Sprachmodell verbunden. Dieses Verfahren heißt Retrieval Augmented Generation, kurz RAG.
AnythingLLM macht diesen Aufbau für Demonstrationen und eigene Installationen zugänglich. Das Tool ist ein anschauliches Beispiel – aber keine Abkürzung an Datenqualität, Berechtigungen, Betrieb und fachlicher Prüfung vorbei.
RAG verbindet Suche und Textgenerierung
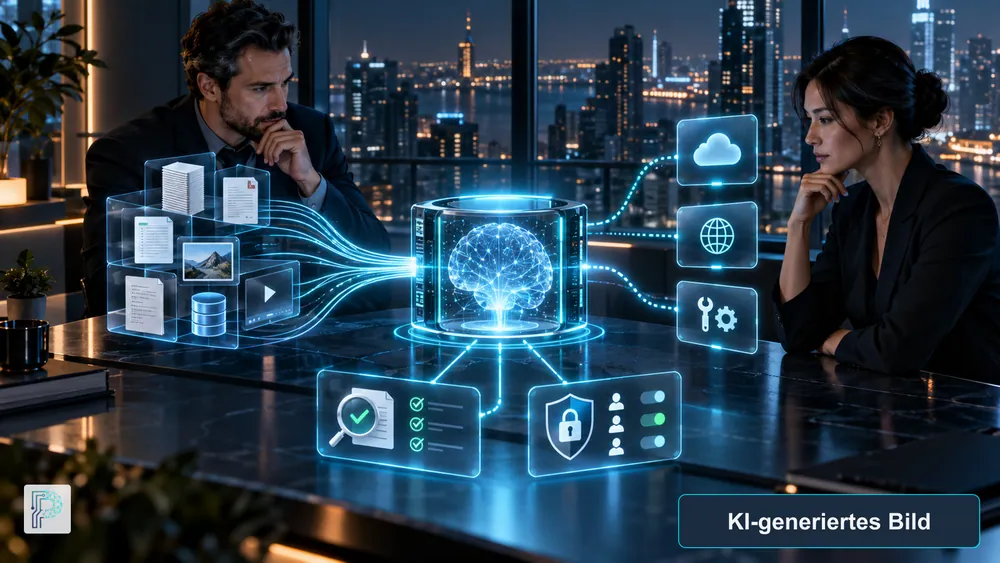
Ein typischer RAG-Ablauf besteht aus mehreren Schritten:
- Dokumente werden eingelesen und in kleinere Abschnitte zerlegt.
- Ein Embedding-Modell übersetzt diese Abschnitte in mathematische Repräsentationen.
- Eine Vektordatenbank speichert Abschnitte und Repräsentationen.
- Bei einer Frage sucht das System nach wahrscheinlich relevanten Abschnitten.
- Frage und Treffer werden an ein Sprachmodell übergeben.
- Das Modell formuliert daraus eine Antwort, idealerweise mit Fundstellen.
Das Sprachmodell wird dabei üblicherweise nicht mit den Unternehmensdokumenten neu trainiert. Es erhält ausgewählte Ausschnitte als zeitweiligen Kontext. Das erleichtert Aktualisierungen, garantiert aber weder vollständige Treffer noch richtige Antworten.
Zwei Fehlerklassen getrennt betrachten
Bei einem wissensbasierten Assistenten können mindestens zwei grundsätzlich verschiedene Fehler auftreten:
- Retrieval-Fehler: Die Suche findet die relevante Passage nicht oder wählt eine veraltete beziehungsweise unpassende Quelle.
- Generierungsfehler: Die richtige Passage liegt vor, das Sprachmodell fasst sie aber falsch, unvollständig oder zu selbstsicher zusammen.
Eine reine Bewertung der flüssig formulierten Antwort verdeckt diesen Unterschied. Ein Pilot sollte deshalb sowohl die gefundenen Quellen als auch die daraus erzeugte Antwort bewerten. Für besonders wichtige Aussagen muss die Originalquelle erreichbar bleiben.
AnythingLLM als Beispiel – nicht als fertige Unternehmensarchitektur
AnythingLLM verbindet Dokumentenverarbeitung, Arbeitsbereiche, Vektorsuche und unterschiedliche Modellanbieter in einer Oberfläche. Laut aktueller AnythingLLM-Dokumentation lassen sich lokale und cloudbasierte Sprachmodelle sogar parallel konfigurieren. System-, Workspace- und Agent-Modelle können voneinander abweichen.
Damit eignet sich das Tool, um RAG-Abläufe zu verstehen und Varianten zu erproben. Die Konfigurierbarkeit bedeutet zugleich: Der Name „AnythingLLM“ allein beschreibt den Datenfluss nicht.
Desktop und selbst gehosteter Mehrbenutzerbetrieb unterscheiden
Die Desktop-Anwendung dient vor allem der Nutzung auf einem einzelnen Rechner. Für mehrere Nutzer stellt das Projekt eine selbst gehostete Servervariante bereit. Die Projektbeschreibung nennt unter anderem Mehrbenutzerunterstützung, Dokumentenpipelines sowie lokale und Cloud-Modelle.
Ein Desktop-Test belegt daher noch nicht, dass dieselbe Konfiguration als interner Dienst sicher, skalierbar und administrierbar ist. Im Mehrbenutzerbetrieb kommen Authentifizierung, Rollen, Netzwerkabsicherung, Sicherung, Protokollierung, Updates und Kapazitätsplanung hinzu.
„Self-hosted“ ist nicht automatisch „alles bleibt intern“
Nach den Bedingungen für die selbst gehostete Variante hat Mintplex keinen Zugriff auf Dokumente, Chatverläufe, Einstellungen oder Embeddings in der eigenen Instanz. Ein Betrieb ohne Internet ist möglich, wenn lokale Anbieter für Sprachmodell und Vektordatenbank eingesetzt werden.
Für den tatsächlichen Verarbeitungspfad sind jedoch alle Komponenten zu prüfen:
- Sprachmodell und dessen Endpunkt,
- Embedding-Modell,
- Vektordatenbank,
- Dokumenten- und Web-Importer,
- Agenten, Erweiterungen und externe Werkzeuge,
- Telemetrie, Updates und nachgeladene Modelle,
- Sicherungen und Protokolle.
Wird beispielsweise ein selbst gehostetes AnythingLLM mit einem Cloud-Sprachmodell verbunden, verlassen Frage und bereitgestellter Kontext die eigene Instanz entsprechend der Konfiguration. Eine pauschale Aussage wie „AnythingLLM ist lokal und deshalb datenschutzkonform“ wäre falsch. Dieser Beitrag ersetzt keine Datenschutz- oder Rechtsprüfung.
Quellenqualität ist mehr als ein Datei-Upload
RAG kann nur auf Inhalte zugreifen, die verarbeitet und auffindbar gemacht wurden. Vor einem Pilot sollten Unternehmen deshalb festlegen:
- Welche Quelle ist für einen Sachverhalt verbindlich?
- Wer ist für Inhalt und Aktualisierung verantwortlich?
- Welche Version ist gültig und welche muss entfernt werden?
- Welche Personen dürfen Dokument und abgeleitete Antwort sehen?
- Sind Tabellen, Scans, Fußnoten und Anhänge technisch korrekt ausgelesen?
- Wie schnell müssen Änderungen in den Suchindex gelangen?
Widersprüchliche oder veraltete Dokumente werden durch RAG nicht automatisch bereinigt. Das System kann den Konflikt übersehen oder eine der Varianten überzeugend wiedergeben.
Berechtigungen müssen bis zur Antwort reichen
Ein Wissensassistent darf Informationen nicht allein deshalb anzeigen, weil sie technisch indexiert wurden. Die Zugriffsrechte der Originalsysteme müssen bei Import, Speicherung, Suche und Antwort berücksichtigt werden.
Ein häufiger Pilotfehler ist ein gemeinsamer Dokumentenbestand, obwohl einzelne Nutzer nicht alle Quellen sehen dürfen. Arbeitsbereiche oder Rollen im KI-Werkzeug lösen das Problem nur, wenn sie korrekt mit den fachlichen Berechtigungen und Aktualisierungsprozessen verbunden sind. Vor dem Import sensibler Inhalte sollte geklärt sein, wie Rechteänderungen und Löschungen in den Index übertragen werden.
Ein RAG-Pilot braucht prüfbare Fragen
Ein sinnvoller Test beginnt nicht mit allen verfügbaren Dokumenten, sondern mit einem begrenzten Bestand und realen Aufgaben. Ein möglicher Ablauf:
- Einen fachlich verantworteten Dokumentensatz auswählen.
- Typische Fragen, Grenzfälle und Fragen ohne belegte Antwort sammeln.
- Erwartete Quellen und Kernaussagen vorab dokumentieren.
- Retrieval-Treffer, Antwort und Zitate getrennt bewerten.
- Falschantworten, unbegründete Sicherheit und verweigerte Antworten erfassen.
- Aktualisierung, Löschung und Berechtigungsänderung praktisch testen.
Wichtige Kennzahlen sind nicht nur Antwortzeit oder Nutzerzufriedenheit, sondern beispielsweise die Trefferquote bei belegbaren Fragen, korrektes Ablehnen bei fehlender Grundlage und der Anteil notwendiger fachlicher Korrekturen.
Quellenanzeige hilft, ersetzt aber keine Prüfung
Eine Quellenangabe erhöht die Nachvollziehbarkeit nur, wenn sie auf die tatsächlich verwendete Passage führt und der Nutzer das Original öffnen darf. Ein formal passendes Zitat kann eine Aussage trotzdem unzureichend stützen. Bei verbindlichen Richtlinien, Verträgen oder sicherheitsrelevanten Anweisungen sollte die Antwort deshalb als Orientierung dienen und zur maßgeblichen Originalquelle führen.
Wissensbasierte KI klar von lokaler KI abgrenzen
RAG und lokaler Betrieb sind zwei verschiedene Entscheidungen. Ein RAG-System kann vollständig in der Cloud, vollständig auf eigener Infrastruktur oder hybrid betrieben werden. Umgekehrt kann ein lokales Sprachmodell ohne angebundene Wissensbasis arbeiten.
Der Beitrag „Lokale KI mit Ollama und LM Studio“ erläutert Hardware, lokale und cloudbasierte Betriebsmodi sowie Modelllizenzen. Hier steht dagegen die verlässliche Nutzung eigener Quellen im Mittelpunkt.
Fazit
AnythingLLM zeigt verständlich, wie Dokumentensuche und Sprachmodell zusammenspielen. Eine belastbare Unternehmenslösung entsteht aber erst durch kuratierte Quellen, durchgängige Berechtigungen, transparente Datenflüsse, geregelten Betrieb und einen Test, der Retrieval und Antwortqualität getrennt misst.
Im Workshop „Wissensnutzung mit KI verstehen“ ordnen Sie das RAG-Prinzip, typische Fehlannahmen und geeignete nächste Prüfschritte für Ihre Wissensbestände ein.
Quellen und Stand
Fachlich geprüft am 25. September 2026. Verwendet wurden aktuelle Projektquellen:
Häufig gestellte Fragen
Vom Wissen zur Umsetzung
Sie möchten dieses Thema praktisch vertiefen? In unserem Workshop arbeiten wir gemeinsam an konkreten Lösungen für Ihr Unternehmen.
Workshop entdecken